AIプロジェクトの要件定義|精度目標・検収条件・データ要件の決め方
AIを使ったシステムを外注しようとして、「要件定義で何を決めればよいのか分からない」と悩む担当者は少なくありません。通常のシステム開発と同じ感覚で進めると、開発が終わってから「精度が足りない」「どこまでできたら完成なのか」で揉めることになります。
AIの出力は確率的で、同じ入力でも100%正しい結果は保証できません。そのため、機能の一覧に加えて「どの程度の精度なら業務で使えるか」「そのためにどんなデータが必要か」「何をもって検収とするか」を、開発前に発注者と開発会社で合意しておく必要があります。
この記事では、AIプロジェクトの要件定義の進め方を6つのステップで解説します。精度目標・データ要件・検収条件の決め方と、要件定義書に書く項目も紹介するので、AI開発の発注準備にお役立てください。
AIの要件定義は「精度目標・データ要件・検収条件」の3点を、PoCで検証しながら段階的に固めるのが基本です!
まず、通常のシステム開発とAIプロジェクトで、要件定義に書く内容がどう変わるかを一覧で示します。
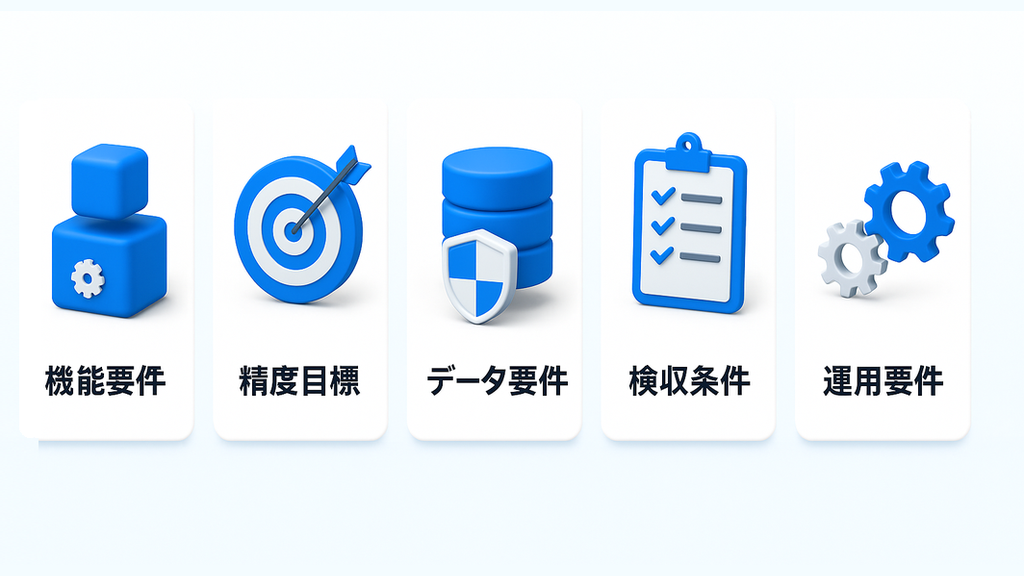
| 項目 | 通常のシステム開発 | AIプロジェクト |
|---|---|---|
| 機能要件 | 画面・処理・帳票を仕様どおりに定義 | AIに任せる範囲と、人が判断する範囲を分けて定義 |
| 品質の基準 | 仕様どおりに動くか(合否が明確) | 評価データで何%正しいか(精度目標で定義) |
| データ | 既存データの移行・連携が中心 | 学習・参照・評価に使うデータの量・品質・権利を定義 |
| 検収条件 | テスト仕様書の全項目合格 | 評価データでの合格ラインと、評価手順を事前に合意 |
| 運用 | 障害対応・保守が中心 | 精度の監視、データ更新、モデル変更への対応を含む |
| 進め方 | 要件を固めてから開発 | PoCで検証し、要件を段階的に確定 |
この表は、経済産業省の契約ガイドライン・チェックリストや産総研の品質ガイドラインなどの公的資料を参考に、本記事で整理したものです。すべてのAI案件に当てはまる公式の区分ではありません。
画像を分類するAI、文章を生成するAI、既存のLLM(大規模言語モデル)を業務システムに組み込むAIエージェントなど、種類によって重視する項目は変わります。自社の案件にどう当てはめるかは、次の章から順に確認しましょう。
システム開発全般の要件定義の進め方は、システム開発の要件定義を完全ガイドで詳しく解説しています。本記事では、AI特有の部分に絞って説明します。
AIプロジェクトの要件定義とは|通常のシステム開発と違う3つの点
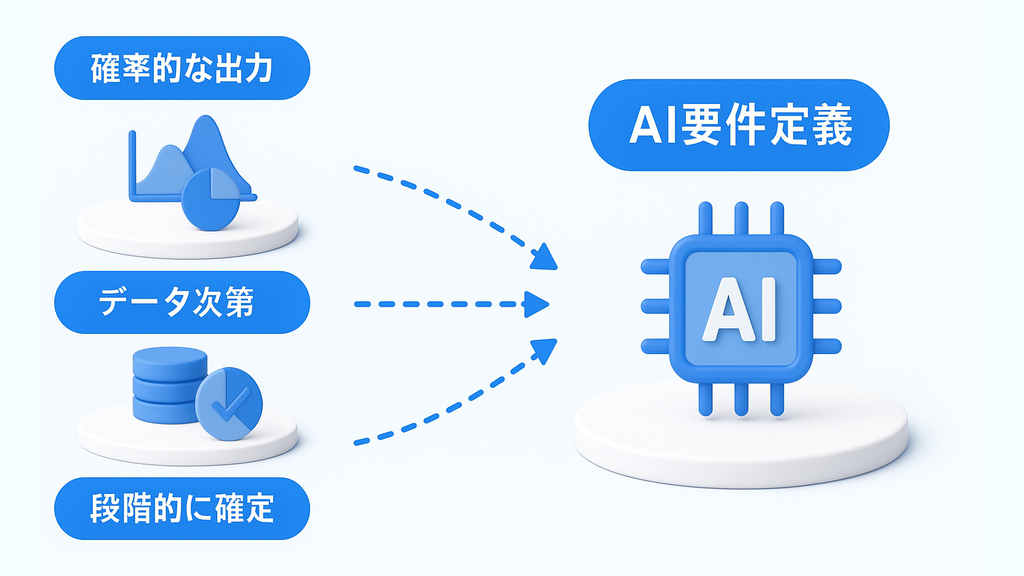
AIプロジェクトの要件定義は、通常のシステム開発の要件定義に「精度」「データ」「検証」の考え方を加えたものです。何が違うのかを先に押さえておくと、開発会社との打ち合わせで論点がぶれにくくなります。
出力が確率的で「必ず正しい」を前提にできない
通常のシステムは、同じ入力に対して仕様どおりの出力を返します。AIは過去のデータから傾向を学習して判断するため、一定の割合で誤りを含みます。
経済産業省の「AIの利用・開発に関する契約チェックリスト」は、AIモデルが学習用データセットに基づく帰納的な手法で開発されることから、完成義務の設定や性能保証が必ずしも容易でないと整理しています。
出典・参考:経済産業省「AIの利用・開発に関する契約チェックリスト」(令和7年2月) AIの利用・開発に関する契約チェックリスト(PDF)
要件定義では「誤りをゼロにする」ではなく「どの程度の誤りなら業務で許容できるか」を決めます。
実現できる品質はデータの状態で決まる
AIの精度は、使えるデータの量と質に大きく左右されます。対象業務の典型的なケースしかデータがなければ、例外的なケースではうまく判断できません。
既存のLLMを使う場合でも、社内文書を参照させる仕組みでは、文書の古さや表記ゆれが回答の品質に直結します。データの棚卸しは、機能を決めるのと同じくらい重要な要件定義の作業です。
要件は検証しながら段階的に確定する
AIは、実際のデータで試すまで「どこまでできるか」が分からない部分があります。そのため、最初にすべての要件を固めるのではなく、検証の結果を見て要件を確定させる進め方が向いています。
経済産業省の「AI・データの利用に関する契約ガイドライン」は、学習済みモデルの開発について、アセスメント・PoC(概念実証)・開発・追加学習の段階に分けて進める「探索的段階型」の考え方を示しています。
出典・参考:経済産業省「AI・データの利用に関する契約ガイドライン 1.1版」 AI・データの利用に関する契約ガイドライン(PDF)
生成AIの業務活用は広がっています。総務省の令和7年版情報通信白書では、生成AIを「積極的に活用する方針」「活用する方針」と回答した日本企業は、2024年度調査で合計49.7%でした(2023年度は42.7%)。
出典・参考:総務省「令和7年版 情報通信白書」業務における生成AI活用の現況 令和7年版 情報通信白書の該当ページ
活用方針を決めた企業が次に直面するのが、「何を作り、どこまでできれば成功か」を具体化する作業です。この具体化こそが、AIプロジェクトの要件定義にあたります。
業務に合わせたAIエージェントを開発
その業務、AIで自動化できるか無料で診断します
- AIを使いたいが、どの業務から手をつければいいか分からない
- PoC(試作・検証)で止まり、現場で使われるところまで進まない
- 社内にAIに詳しいエンジニアがいない
 八木(Last Scene)
週1回の定例で動くものをお見せしながら、御社だけで運用できる状態まで伴走します。
「この作業は自動化できる?」の一問からご相談ください。
AI要件定義の進め方6ステップ
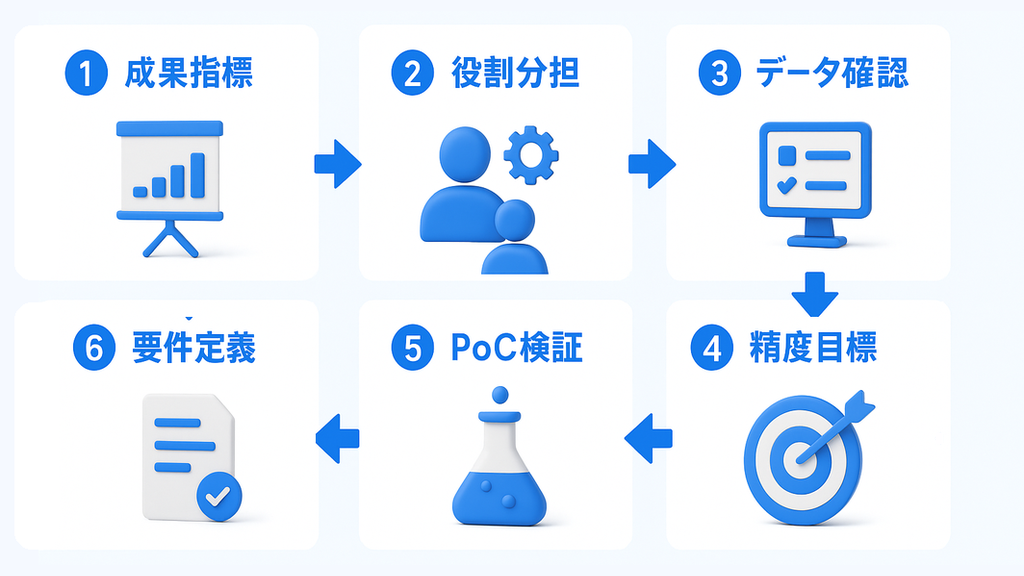
AIプロジェクトの要件定義は、次の6ステップで進めると抜け漏れを防げます。
- 業務課題と成果指標(KPI)を決める
- AIに任せる範囲と、人が判断する範囲を分ける
- データの有無と品質を棚卸しする
- 精度目標と評価方法を決める
- PoCで検証し、要件を確定する
- 検収条件と運用要件を要件定義書にまとめる
ステップ1〜4は発注者が主体になって決める部分です。開発会社に丸投げせず、業務を知っている担当者が関わりましょう。
ステップ1. 業務課題と成果指標(KPI)を決める
最初に、AIで解決したい業務課題と、成果を測る指標を決めます。「AIで効率化したい」ではなく、「問い合わせの一次振り分けにかかる時間を月100時間から30時間に減らす」のように、数値で書ける状態を目指しましょう。
成果指標は、AIの精度そのものではなく業務の指標にします。精度が高くても、業務の時間やコストが減らなければ導入の意味がないためです。
ステップ2. AIに任せる範囲と、人が判断する範囲を分ける
AIは一定の割合で誤るため、誤りを誰がどう拾うかを業務フローに組み込みます。たとえば「AIが下書きを作り、担当者が確認して送信する」「確信度が低いものだけ人が判断する」といった分担です。
この分担によって、必要な精度は大きく変わります。人が全件を確認する設計なら、精度が多少低くても業務は回ります。
ステップ3. データの有無と品質を棚卸しする
AIに学習させる、または参照させるデータが、どこに、どれだけ、どんな形式であるかを洗い出します。紙や個人のメールボックスにしかない情報は、整備の工数が別途かかります。
評価に使うデータも、この段階で確保のめどを立てておきます。詳しくは「データ要件の決め方」の章で解説します。
ステップ4. 精度目標と評価方法を決める
ステップ1〜3を踏まえて、「どのデータで」「どの指標を使い」「何%以上なら合格か」を決めます。数値の決め方は次の章で計算例とともに紹介します。
この時点の精度目標は仮置きで構いません。PoCの結果を見て、実現可能な水準に調整します。
ステップ5. PoCで検証し、要件を確定する
PoCでは、実際のデータを使って精度目標に届くかを検証します。届かない場合は、データを増やす、人の確認を増やす、対象業務を絞るといった形で要件を見直しましょう。
PoCの費用や、PoC後に追加で発生するコストは、AIエージェント開発の費用相場で整理しています。
ステップ6. 検収条件と運用要件を要件定義書にまとめる
PoCで確認した精度をもとに、本開発の検収条件と、運用開始後の精度監視やデータ更新の方法を要件定義書にまとめます。発注者と開発会社の双方で読み合わせを行い、合意した内容を契約に反映させます。
 八木(Last Scene)
PoCの前に「何%なら合格か」を仮でも決めておくと、PoCが「なんとなく試して終わり」になりません!
業務に合わせたAIエージェントを開発
その業務、AIで自動化できるか無料で診断します
- AIを使いたいが、どの業務から手をつければいいか分からない
- PoC(試作・検証)で止まり、現場で使われるところまで進まない
- 社内にAIに詳しいエンジニアがいない
八木(Last Scene)週1回の定例で動くものをお見せしながら、御社だけで運用できる状態まで伴走します。
「この作業は自動化できる?」の一問からご相談ください。
精度目標の決め方|業務で許容できる誤りから逆算する
精度目標は「高いほど良い」ではありません。精度を上げるほど、データ整備や調整の工数は増えます。業務で許容できる誤りの量から逆算して、必要十分な水準を決めましょう。
評価指標は「どの誤りが困るか」で選ぶ
分類や検知を行うAIでは、正解率だけでなく、適合率と再現率を確認します。どちらを重視するかは、業務でどちらの誤りが困るかで決まります。
適合率は「AIが該当と判定したもののうち、本当に該当だった割合」、再現率は「本当に該当するもののうち、AIが拾えた割合」です。不正検知のように見逃しが困る業務では再現率を、誤って止めると困る業務では適合率を重視します。
| 業務の例 | 困る誤り | 重視する指標 |
|---|---|---|
| 不良品・不正の検知 | 見逃し | 再現率 |
| 問い合わせの自動振り分け | 誤った部署への振り分け | 正解率・適合率 |
| 契約書のリスク条項チェック | 見落とし | 再現率(人の確認と併用) |
| 生成AIによる回答の下書き | 事実と異なる回答 | 評価観点ごとの合格率 |
生成AIは「評価観点×採点基準」で測る
文章を生成するAIは、正解が1つに決まらないため、正解率だけでは測れません。「事実と合っているか」「社内規程に沿っているか」「不適切な表現がないか」など、評価観点ごとに採点基準を決めて合格率を測ります。
AIセーフティ・インスティテュート(AISI)の「AIセーフティに関する評価観点ガイド」は、有害情報の出力制御、偽誤情報の出力・誘導の防止、公平性と包摂性、プライバシー保護、セキュリティ確保、ロバスト性、データ品質など10の評価観点を挙げています。
出典・参考:AIセーフティ・インスティテュート「AIセーフティに関する評価観点ガイド(第1.10版)」(2025年3月) AIセーフティに関する評価観点ガイド
すべての観点を同じ重さで扱う必要はありません。社内向けの検索AIと、顧客に直接回答するAIでは、求められる水準が異なります。用途に応じて、重視する観点を選びましょう。
精度目標の計算例|誤りの件数と手戻り時間から許容ラインを出す
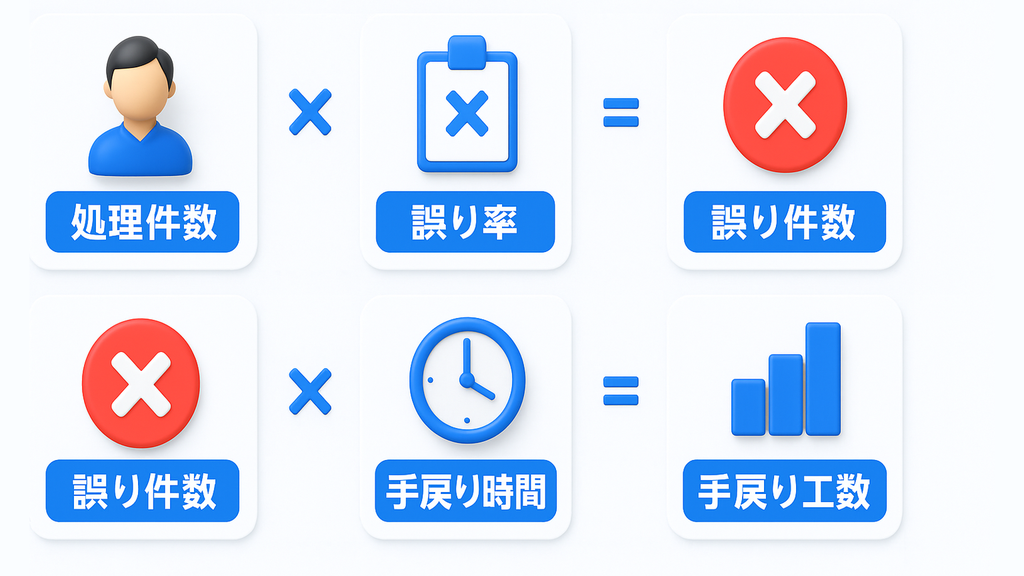
ここでは、問い合わせメールをAIで部署ごとに自動振り分けする例で、精度目標の考え方を示します。自社の数値に置き換えて計算してみてください。
前提は、問い合わせが月3,000件、現在は全件を人が振り分けて1件2分(月100時間)、AIが誤った場合の手戻りが1件10分とします。いずれも説明用の仮の数値です。
| AIの正解率 | 月の誤り件数 | 手戻り時間(月) | 現状との差 |
|---|---|---|---|
| 80% | 600件 | 100時間 | 削減なし |
| 90% | 300件 | 50時間 | 50時間削減 |
| 95% | 150件 | 25時間 | 75時間削減 |
誤りの件数は「処理件数×(1−正解率)」、手戻り時間は「誤りの件数×1件あたりの手戻り時間」で計算します。この例では、正解率80%で手戻り時間が現状と同じになるため、80%を超えることが最低条件です。
実際には、誤った振り分けによる顧客への影響や、AIの利用料・保守費も加味します。「90%以上」を目標に置き、残りは担当者が確認する運用にするなど、業務フローとセットで決めましょう。
評価データは発注者が用意する
精度を測るには、正解がわかっている評価データが必要です。評価データは、実際の業務で発生するケースを代表している必要があるため、業務を知っている発注者側で用意するのが基本です。
目安として、よくあるケースだけでなく、判断が分かれるケースや例外的なケースも含めます。評価データの件数や作り方は、開発会社と相談して決めましょう。
評価データを開発会社だけで作ると、検収時に「実務と違う」という認識のずれが起きやすくなります。
業務に合わせたAIエージェントを開発
その業務、AIで自動化できるか無料で診断します
- AIを使いたいが、どの業務から手をつければいいか分からない
- PoC(試作・検証)で止まり、現場で使われるところまで進まない
- 社内にAIに詳しいエンジニアがいない
八木(Last Scene)週1回の定例で動くものをお見せしながら、御社だけで運用できる状態まで伴走します。
「この作業は自動化できる?」の一問からご相談ください。
データ要件の決め方|量・品質・権利・更新の4項目
データ要件は、「量」「品質」「権利」「更新」の4項目で整理すると抜け漏れを防げます。
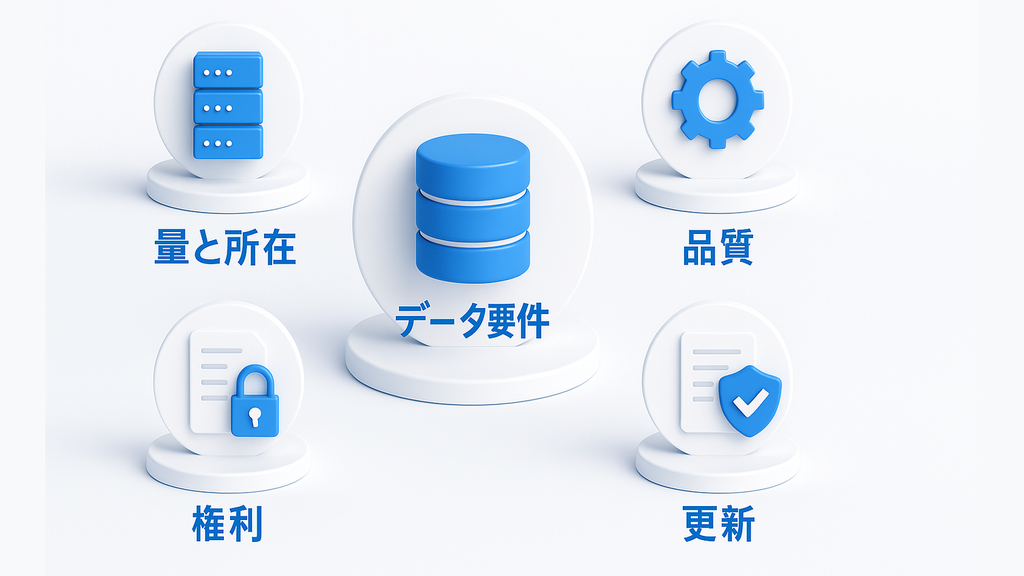
| 項目 | 確認すること | 決める人 |
|---|---|---|
| 量・所在 | どこに、何件、どの形式であるか | 発注者 |
| 品質 | 偏り・欠損・表記ゆれ・正解ラベルの正しさ | 発注者と開発会社 |
| 権利・個人情報 | 利用してよい範囲、個人情報・機密情報の有無 | 発注者(法務) |
| 更新 | 更新の頻度と、更新後の精度確認の方法 | 発注者と開発会社 |
量と所在|学習・参照・評価に使うデータを分けて洗い出す
AIで使うデータは、学習に使うデータ、回答時に参照させるデータ、精度を測る評価データの3種類に分けて洗い出します。同じデータを学習と評価の両方に使うと、実力以上に精度が高く見えるため注意しましょう。
既存のLLMをそのまま使う場合、学習データは不要なこともあります。その場合も、参照させる社内文書と評価データは必要です。
品質|偏り・欠損・ラベルの正しさを確認する
産業技術総合研究所の「機械学習品質マネジメントガイドライン」は、品質管理の対象として「データセットの被覆性」「データセットの均一性」「データの妥当性」などの内部品質特性を挙げています。
出典・参考:産業技術総合研究所「機械学習品質マネジメントガイドライン 第4版」 機械学習品質マネジメントガイドライン
発注者の立場では、「想定するケースがデータに十分含まれているか」「特定の時期や部署に偏っていないか」「正解ラベルが正しく付いているか」を確認すると、実務で役立ちます。
権利と個人情報|入力してよいデータの範囲を決める
AIに入力するデータに個人情報や機密情報が含まれる場合、利用目的の範囲内か、外部のAIサービスが入力データを学習に使わないかを確認する必要があります。
個人情報保護委員会は、生成AIサービスに個人情報を含むプロンプトを入力する場合、利用目的の達成に必要な範囲内であることと、サービス提供事業者が機械学習に利用しないことなどを十分に確認するよう注意喚起しています。
出典・参考:個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」(2023年6月) 生成AIサービスの利用に関する注意喚起等
前述の経済産業省の契約チェックリストも、ベンダーが外国に所在する場合は個人情報保護法の越境移転規制にも注意が必要だとしています。どのデータを、どのサービスに、どの条件で渡すかを要件として明記しましょう。
更新|運用中にデータと精度をどう保つか
業務の内容や取り扱う商品が変われば、AIの精度は徐々に下がります。前述の機械学習品質マネジメントガイドラインも、運用時の継続的なモニタリングと「運用時品質の維持性」を品質管理の対象に含めています。
要件定義では、データを更新する頻度、更新する担当者、更新後に精度を再確認する方法を決めておきます。
検収条件の決め方|「何をもって完成か」を先に合意する
AIプロジェクトで最も揉めやすいのが検収です。開発が終わってから合格ラインを話し合うと、発注者は「期待より低い」、開発会社は「データの限界」と主張が平行線になりがちです。
AIモデルは完成義務・性能保証が難しい
経済産業省の契約チェックリストは、開発型の契約では、ベンダーが完成義務を負うか、負う場合はどのような完成条件(完成時期、検収条件等)が課されるかを確認するよう求めています。
また、成果の内容や水準をどの程度求めるかが重要な論点になることが少なくないとし、開発初期の段階で当事者の認識をすり合わせることが重要だと整理しています。
検収条件は、契約前の要件定義の段階で文書にしておくことが大切です。
検収は「評価データ・合格ライン・手順」の3点で定義する
AIの検収条件は、次の3点を具体的に決めると、あいまいさがなくなります。
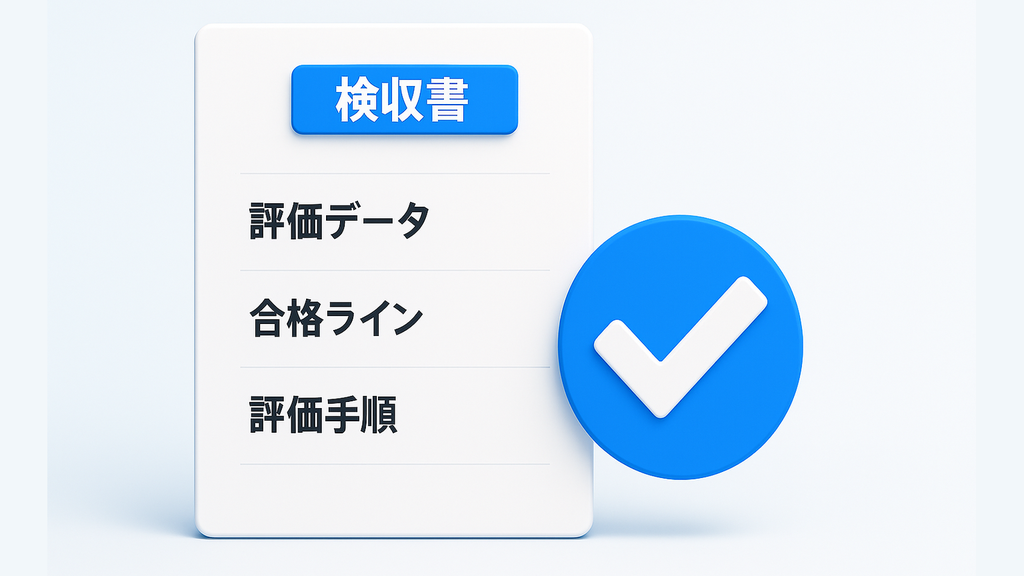
- 評価データ:どのデータ(件数・期間・範囲)で測るか
- 合格ライン:どの指標で何%以上なら合格か
- 評価手順:誰が、どの環境で、何回測るか。判定が分かれたときの扱い
たとえば「2026年4〜6月の問い合わせから抽出した評価データ500件で、振り分けの正解率90%以上」のように書きます。合格ラインに届かなかった場合に、追加の改善期間を設けるのか、契約を終了するのかも決めておきましょう。
準委任と請負は、合意できる成果で選ぶ
精度が事前に読めないPoCや初期開発は、作業の遂行に対して対価を払う準委任契約が選ばれることが多くあります。一方で、画面や連携部分など仕様が明確な部分は、成果物の完成を約束する請負契約にもなじみます。
契約形態の違いと段階別の費用は、AIエージェント開発の費用相場の「準委任と請負」の項で解説しています。発注から検収までの一般的な流れは、システム開発の発注ガイドも参考にしてください。
検収後の精度低下に備える
検収時に合格しても、運用を続けるうちに精度が下がることがあります。利用しているLLMのバージョン更新で、出力の傾向が変わることもあります。
検収後の精度をどう扱うかは、保守契約の範囲として要件定義に含めます。「月1回、評価データで精度を測り、合格ラインを下回ったら改善対応する」といった形で書いておきましょう。
AI要件定義書に書く項目|テンプレートと非機能要件
ここまでの内容を、AI要件定義書の項目として整理します。通常の要件定義書の構成に、AI特有の項目を追加する形で作成します。
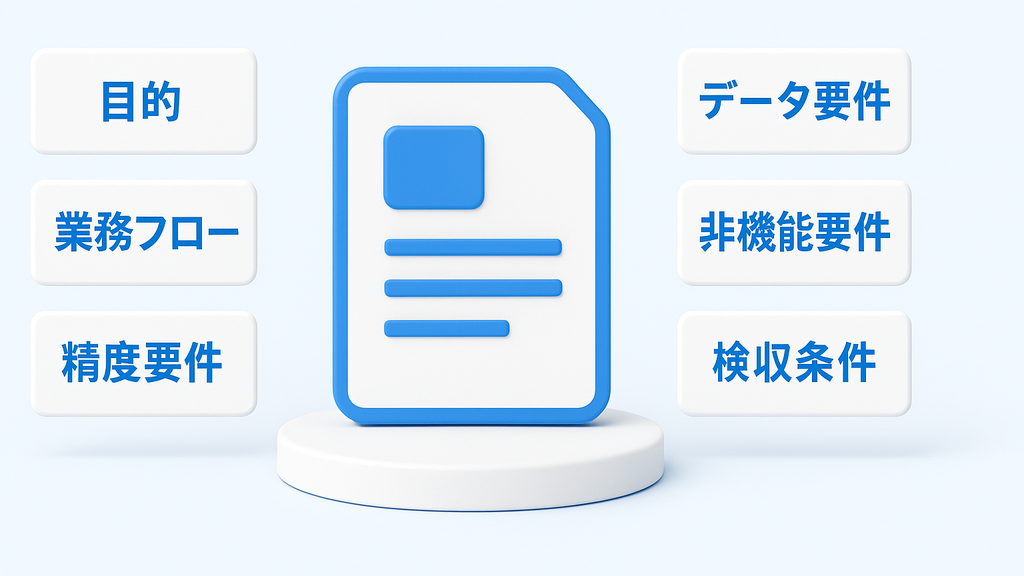
AI要件定義書の目次例
| 章 | 書く内容 | AI特有のポイント |
|---|---|---|
| 1. 目的と成果指標 | 業務課題、KPI、対象範囲 | 精度ではなく業務の指標で書く |
| 2. 業務フロー | 現行と導入後のフロー | AIと人の分担、確認の手順 |
| 3. 機能要件 | 入力・出力・画面・連携 | 誤りや判定不能時の動き |
| 4. 精度要件 | 評価指標、合格ライン | 評価データと評価手順 |
| 5. データ要件 | 量・品質・権利・更新 | 学習・参照・評価の区別 |
| 6. 非機能要件 | 性能・可用性・セキュリティ | 応答時間、利用料の上限 |
| 7. 検収・運用要件 | 検収条件、保守、精度監視 | モデル更新時の再評価 |
1〜3章は通常の要件定義書と共通です。書き方の基本はシステム開発の要件定義を完全ガイドの「要件定義書に必要な8つの項目」を参照してください。
非機能要件|応答時間・可用性・セキュリティ・利用料
IPAの「非機能要求グレード」は、可用性、性能・拡張性、運用・保守性、移行性、セキュリティ、システム環境・エコロジーの6つの大項目で非機能要求を整理しています。AIプロジェクトでも、この枠組みはそのまま使えます。
出典・参考:IPA(情報処理推進機構)「非機能要求グレード」 非機能要求グレードの公開ページ
AI特有の項目としては、応答にかかる時間の上限、外部AIサービスが停止したときの代替手段、処理量が増えたときの利用料の上限を加えます。LLMの利用料は処理量に応じて変わるため、月額の上限と、上限を超えたときの対応を決めておきましょう。
生成AI特有のリスクへの対策を要件に入れる
生成AIを使う場合は、事実と異なる内容をもっともらしく出力するリスクや、入力された指示によって想定外の動作をするリスクへの対策も要件に含めます。
デジタル庁の「テキスト生成AI利活用におけるリスクへの対策ガイドブック(α版)」は、企画から設計・開発、サービス実施までの工程ごとに、テキスト生成AI固有のリスクと軽減策を整理しています。
出典・参考:デジタル庁「テキスト生成AI利活用におけるリスクへの対策ガイドブック(α版)」(2024年5月) テキスト生成AIのリスク対策ガイドブック(PDF)
AIの開発・提供・利用全般の考え方は、総務省・経済産業省の「AI事業者ガイドライン」にまとまっています。2026年3月に第1.2版が公表され、チェックリストとワークシートも用意されています。
出典・参考:総務省・経済産業省「AI事業者ガイドライン(第1.2版)」(2026年3月) AI事業者ガイドラインの公開ページ
要件定義で抜けやすい項目と、開発会社への質問リスト
要件定義の打ち合わせでは、次の質問を開発会社に投げかけると、抜け漏れを確認できます。
- 精度はどのデータ・どの指標で測る想定ですか?
- PoCの結果、精度目標に届かなかった場合はどう進めますか?
- 評価データは何件程度、どのように用意すればよいですか?
- 入力したデータが外部のAIサービスで学習に使われない設定になりますか?
- 利用しているAIモデルが更新された場合、再評価は保守の範囲に含まれますか?
- 月々の利用料の見込みと、上限を超えたときの対応はどうなりますか?
これらの質問に具体的に答えられるかどうかは、開発会社を選ぶ判断材料にもなります。選び方の基準はAI開発に強い企業の選び方で詳しく紹介しています。
要件定義の失敗がプロジェクト全体に与える影響は、システム開発が失敗する7つの原因でも事例とともに解説しています。
AIの要件定義に関するよくある質問
要件定義の段階で、精度を約束してもらえますか?
実データで検証する前に、特定の精度を約束するのは難しいのが一般的です。まずPoCで実現できる水準を確認し、その結果をもとに本開発の合格ラインを合意する進め方をおすすめします。
最初から精度保証を強く求めると、開発会社がリスクを見積もりに上乗せし、費用が高くなることもあります。
データが少なくても、AIプロジェクトは始められますか?
始められる場合があります。既存のLLMを使う場合は、大量の学習データがなくても、参照させる文書と評価データがあれば検証できます。
一方で、自社固有の判断をAIに学習させる場合は、一定量のデータが必要です。データを蓄積する仕組みづくりから始めるかどうかも、要件定義の段階で判断しましょう。
AIの要件定義にかかる期間と費用の目安は?
本記事独自の概算では、対象業務が1つに絞れている場合で2〜6週間程度、工数は0.5〜2人月程度が目安です。人月単価80万円を仮定すると、40万〜160万円程度になります。
これは確定見積もりではなく、PoCの実施費用、API利用料、サーバー費、保守費、消費税は含みません。対象業務の数やデータの整備状況によって変わるため、開発会社に見積もりの前提を確認しましょう。
まとめ|AIの要件定義は「精度・データ・検収」を先に合意する
AIの出力は確率的で、性能を事前に保証することは難しいため、通常のシステム開発の要件定義に「精度目標」「データ要件」「検収条件」を加えて定義します。
進め方は、業務課題とKPIの決定、AIと人の分担、データの棚卸し、精度目標の設定、PoCでの検証、要件定義書へのまとめの6ステップです。精度目標は業務で許容できる誤りから逆算し、検収条件は評価データ・合格ライン・評価手順の3点で具体化しましょう。
検収条件を開発前に文書で合意しておくことが、AIプロジェクトを成功させる一番の近道です!
要件定義前の準備チェックリスト
- AIで解決したい業務課題と、成果を測るKPIを数値で書けるか
- AIが誤ったときに、誰がどう確認・修正するかを決めたか
- 学習・参照・評価に使うデータの所在と件数を把握しているか
- 外部のAIサービスに入力してよいデータの範囲を社内で確認したか
- 精度目標と評価データについて、開発会社と話し合う準備ができているか
株式会社Last Sceneでは、AIを業務に組み込むシステムの開発を、要件定義から運用改善まで一貫して伴走しています。
対象業務の整理や精度目標の設定、PoCでの検証、検収条件の文書化まで、発注者の担当者と一緒に進めます。運用開始後の精度監視や、社内で改善を回せる体制づくりもご支援しています。
「何から決めればよいか分からない」「費用の目安だけ知りたい」という段階でも構いません。まずは実現したいことをお聞かせください。
業務に合わせたAIエージェントを開発
その業務、AIで自動化できるか無料で診断します
- AIを使いたいが、どの業務から手をつければいいか分からない
- PoC(試作・検証)で止まり、現場で使われるところまで進まない
- 社内にAIに詳しいエンジニアがいない
八木(Last Scene)週1回の定例で動くものをお見せしながら、御社だけで運用できる状態まで伴走します。
「この作業は自動化できる?」の一問からご相談ください。